
比特币的交易数据不存在某一家公司的服务器里,而是”人手一份”地存在全球成千上万台全节点电脑上,每台电脑都保存着一份完整的账本副本,这就是它去中心化的核心。你想查某笔交易或某个地址,不用登录哪个平台后台,直接打开”区块链浏览器”输入地址或交易哈希就能看。下面把”存在哪”和”在哪看”两件事说清楚。
一、数据到底存在哪里
说白了,比特币没有中心数据库。它是一本”全球共享的流水账”,每一笔转账都被打包进区块,区块一个一个连起来,形成区块链。
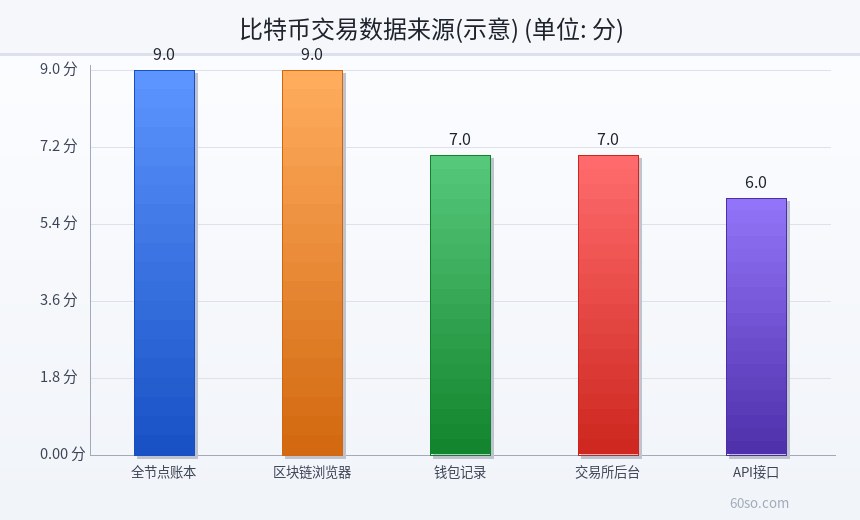
下图是查看比特币交易数据的主要来源(示意评分):
- 全节点账本(最权威):完整保存自创世区块以来的所有交易,自己就可以验证真伪。
- 区块链浏览器:把链上数据整理成网页或查询接口,普通用户最常用。
- 钱包记录:只显示和你自己地址相关的交易,方便但不全面。
- 交易所后台:只反映你在该平台的充提记录,不等于链上全貌。
- API 接口:给开发者或程序调用,用来做数据分析。
关键点:全节点才是”原始数据”,浏览器只是把原始数据”翻译”成好读的页面。也就是说,链上数据是”公开、可验证”的,这正是比特币和传统银行账本最大的差别——银行账本你看不到,而比特币账本人人可查。
二、在哪看:区块链浏览器怎么用
区块链浏览器就像一个”链上搜索引擎”。常见的公开浏览器有 Blockchain.com、Blockstream、Mempool.space 等(这里只是举例说明工具类型,不构成任何推荐)。
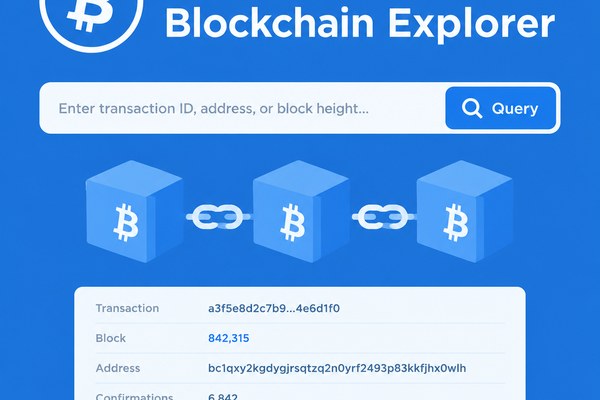
上图是区块链浏览器查询概念示意。
用法很简单:
- 打开浏览器页面;
- 把地址或交易哈希(TxID)粘贴进搜索框;
- 看余额、转账金额、时间、确认数、手续费等信息。
你能查到的是:某地址有多少币、收付过哪些交易、某笔交易被多少个区块确认。你查不到的是:这个地址背后到底是哪个人——钱包地址和真人身份并不直接对应,比特币是”伪匿名”而不是完全匿名。
三、数据体积越来越大
区块链是”只增不减”的。随着交易不断累积,完整账本的数据体积在持续增长。
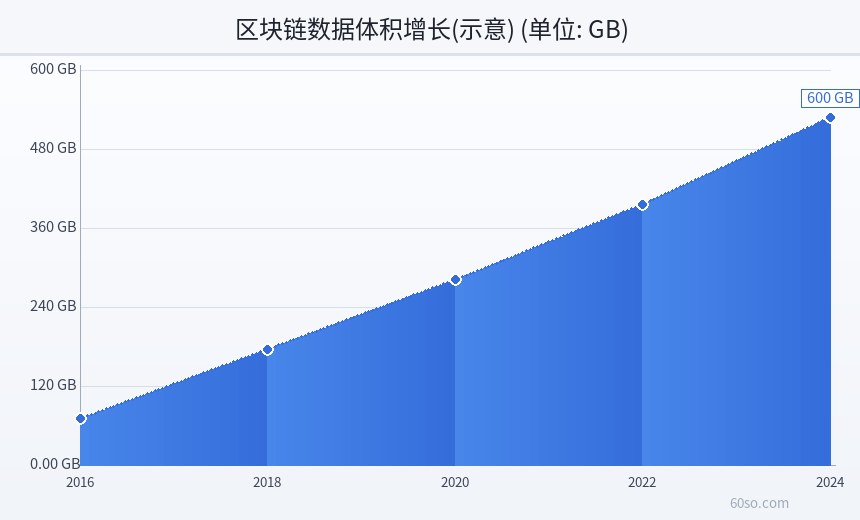
下图是区块链数据体积增长的示意(非真实精确值):
这条曲线几乎是单向上行的,所以运行一个全节点的硬件门槛也在慢慢提高。这也是为什么有人主张用”轻节点”或裁剪节点来降低存储负担。
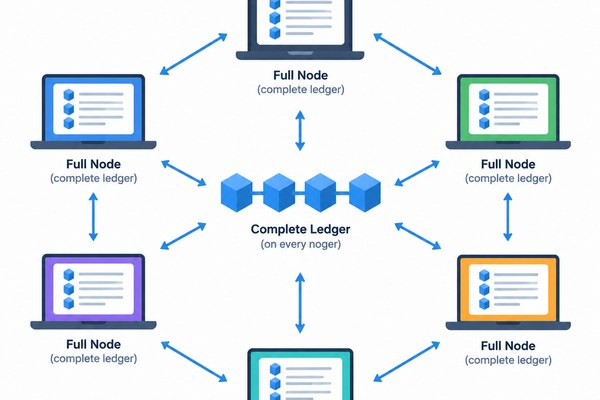
上图是”分布式全节点账本”的概念示意图。
四、全节点、轻节点、浏览器是什么关系
- 全节点:下载并校验全部数据,是网络的”骨架”,自己就能确认一笔交易真伪。
- 轻节点:只下载区块头,靠”简单支付验证(SPV)”向全节点询问,省空间但依赖他人。
- 区块链浏览器:本质是某个机构跑了一个(或接入了)全节点,再把数据做成网页服务给你看。
所以浏览器是”方便”的工具,但它的数据源头仍然是全节点。理论上如果你不信任某个浏览器,自己跑一个全节点验证即可。
五、普通人查数据的几个提醒
- 确认数不是越多越”好”,只是越稳:一般 1~3 个确认小额就够用,大额建议 6 个以上。
- 哈希要核对:转账时先小额测试,拿到 TxID 再去浏览器核对。
- 浏览器不止一个:遇访问不畅可以换个公开浏览器交叉验证。
- 隐私意识:地址一旦和你的身份关联,历史记录都公开可查,尽量别重复使用同一地址。
六、几个常见问题
- 为什么同一笔交易在不同浏览器显示不一样?多半是缓存和确认数更新的时差,换个浏览器交叉核对即可。
- 交易一直”未确认”是什么情况?往往是手续费给低了,卡在内存池里,可以继续等或尝试加速。
- 能查到某个地址属于谁吗?链上只显示地址,链下身份要靠交易所实名信息或执法机构才能关联,普通用户查不到。
- 数据会不会被篡改?要改一个区块就得重算它之后的全部区块,成本极高,这正是区块链”不可篡改”的来源。
- 全节点是不是人人都要跑?不是,普通用户用浏览器或轻钱包即可,全节点更适合想独立验证的人。
七、新手常见误区
- 误区一:以为交易数据存在”比特币公司”的服务器里。比特币没有中心公司,数据分散在全球成千上万台全节点上。
- 误区二:拿交易所的”交易记录”当链上记录。平台内部账本不等于链上转账,尤其是平台内部撮合的那部分。
- 误区三:以为地址能直接对应到人。链上是伪匿名,地址与真实身份没有天然绑定。
- 误区四:认为浏览器显示的余额就等于”到账”。未确认或确认数不足时,显示状态并不等于最终结算。
八、如何核实一笔交易是否真实到账
- 拿到对方发来的交易哈希(TxID),去至少两家公开浏览器查询;
- 核对金额、收付地址和时间,是否与你预期一致;
- 看确认数:小额 1~3 个通常够用,大额建议 6 个以上更稳妥;
- 若状态长期”待确认”,检查手续费是否偏低,必要时考虑加速;
- 金额巨大时,先小额测试再转大额,避免地址填错造成不可逆损失。
九、从数据存储看比特币的设计取舍
链上数据公开、可验证、不可篡改,代价是”全网冗余存储”和”数据只增不减”,这其实是把查询成本和存储成本摊给了整个网络。轻节点、裁剪节点、索引服务(各类 API)都是在这个取舍下衍生出来的方案:有人负责存全量,有人负责做索引,普通用户则通过浏览器这类”翻译层”间接使用。理解这一点,就能明白为什么”自己跑一个全节点”是最不依赖第三方的验证方式,也能明白为什么不要盲目相信单一浏览器显示的结果——工具越方便,越要记得它的数据源头在哪。
十、关于隐私与合规的补充
链上数据是永久公开的:一个地址一旦和你的身份产生关联,它的所有历史收发记录都可能被顺藤摸瓜地翻出来,所以尽量不要长期重复使用同一个地址。需要提醒的是,更换新地址、留意找零地址这类做法只是技术层面的隐私手段,并不等于”合法匿名”;若被用于逃避监管、洗钱等用途,仍然可能违法。另一方面,用公开浏览器查询别人的地址本身是允许的,但把查到的信息用于骚扰、曝光甚至敲诈,同样会触碰法律边界。还要注意,交易所的充提记录受实名制约束,”链上透明”并不意味着”没人知道你是谁”——公共地址与实名身份之间,往往只隔着一层平台信息。把”透明”与”隐私”的关系想清楚,才能在查询数据时既不越界,也不让自己过度暴露。
最后再强调一遍:比特币的交易数据既不属于任何公司,也不靠任何中心机构保管,它属于每一个愿意下载并校验全量数据的参与者。查询时记住三句话——认准原始数据源、用至少两家浏览器交叉核对、把隐私和合规放在心上,基本就能避开绝大多数常见误区和操作风险。
风险提示:本文仅为区块链数据存储与查询方式的客观科普,不构成投资建议。链上交易不可逆,操作前务必仔细核对地址与网络。